Model językowy ChatGPT – jak tworzy tekst i skąd się wziął
Sam model językowy, na którym działa ChatGPT, nie przeszukuje internetu w poszukiwaniu gotowych odpowiedzi ani nie zagląda do żadnej encyklopedii. Na podstawie wpisanego polecenia i wcześniejszej rozmowy przewiduje, jaki fragment tekstu powinien pojawić się dalej, i tak buduje odpowiedź słowo po słowie. Dlatego potrafi napisać płynny szkic artykułu w kilka sekund, ale z równą pewnością siebie poda nieistniejący cytat czy zmyśloną liczbę.
Gdy wiadomo, jak model dzieli tekst na tokeny, czego nauczył się podczas treningu i ile rozmowy jest w stanie wziąć pod uwagę, łatwiej pisać trafne polecenia, wychwytywać błędy i świadomie decydować, jakich informacji nie wpisywać do czatu.
Czym jest model językowy ChatGPT
ChatGPT to narzędzie firmy OpenAI oparte na dużych modelach językowych z rodziny GPT (Generative Pre-trained Transformer). Pod jedną nazwą działa kilka modeli. Kolejne generacje różnią się szybkością, jakością odpowiedzi i obsługiwanymi funkcjami, co dokładniej opisuje porównanie GPT-3.5 a nowsze modele. Zasada działania jest jednak wspólna: model analizuje kontekst i wylicza, jaki ciąg tekstu najlepiej do niego pasuje.
Warto odróżnić dwie warstwy, które w codziennym języku często się zlewają.
- Model językowy przyjmuje tekst i generuje tekst. Sam z siebie nie przechowuje historii rozmów i nie otwiera plików. Ten sam rodzaj modelu może też działać w innych narzędziach, nie tylko w ChatGPT.
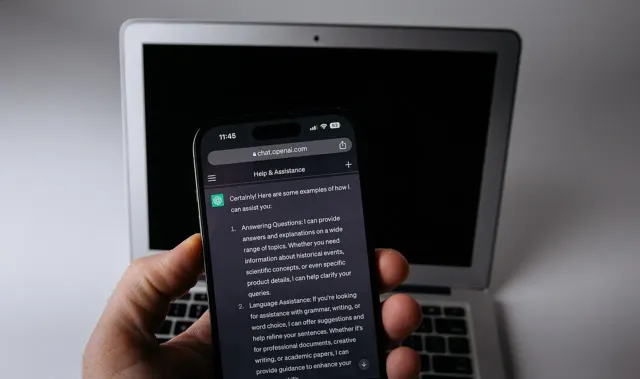
- Aplikacja ChatGPT obejmuje okno rozmowy w przeglądarce lub na telefonie oraz historię czatów. W zależności od wersji dochodzą do tego dodatkowe funkcje, np. przesyłanie plików, dostęp do aktualnych stron internetowych czy praca z obrazem.
Zakres tych funkcji zależy od planu i wersji aplikacji, a do tego dość często się zmienia. Przed wyborem planu albo wdrożeniem narzędzia w firmie warto sprawdzić aktualną dokumentację OpenAI.
ChatGPT nie jest bazą wiedzy ani spisem źródeł. Baza danych zwraca zapisane wcześniej informacje, które można sprawdzić u źródła. Model językowy ChatGPT tworzy odpowiedź ze wzorców wyuczonych podczas treningu i nie ma w sobie katalogu sprawdzonych faktów, do którego mógłby zajrzeć.
Z tego wynika najważniejsza dla użytkownika cecha: płynność tekstu nie świadczy o jego prawdziwości. Zdanie z błędną datą lub nieistniejącym przepisem brzmi równie przekonująco jak zdanie poprawne. W obu przypadkach model wykonuje tę samą pracę, czyli dobiera najbardziej prawdopodobne słowa.
Jak model językowy ChatGPT tworzy tekst krok po kroku
Tokeny i przewidywanie kolejnego słowa
Wpisane polecenie najpierw przechodzi tokenizację. Tekst zostaje podzielony na tokeny, czyli całe słowa, ich fragmenty, znaki interpunkcyjne lub pojedyncze znaki. Model nie liczy na literach ani zdaniach, tylko na tych jednostkach zamienionych na liczby. W polszczyźnie, z bogatą odmianą i długimi wyrazami, jedno słowo często składa się z kilku tokenów. Na przykład „najprawdopodobniej” może zostać rozbite na kilka części.
Następnie do pracy przystępuje architektura transformer z mechanizmem uwagi. Model ocenia, które wcześniejsze fragmenty tekstu są najważniejsze dla kolejnego słowa. W zdaniu „Kubek nie zmieścił się do plecaka, bo był za mały” to właśnie mechanizm uwagi pozwala powiązać „był” z plecakiem, a nie z kubkiem. Dzięki niemu model trzyma się też tematu w długiej wypowiedzi.
Odpowiedź powstaje token po tokenie. Model wylicza prawdopodobieństwa możliwych kontynuacji i wybiera jedną z nich. Wybrany token dołącza do kontekstu, a obliczenia zaczynają się od nowa.
Dlaczego odpowiedzi się różnią
Przy wyborze kolejnego tokenu działa pewien element losowości, więc model nie zawsze sięga po najbardziej prawdopodobną opcję. Z tego powodu to samo polecenie wpisane dwa razy daje inne sformułowania, a czasem także inną strukturę tekstu. Przy szkicach i pomysłach to zaleta, bo z kilku wersji łatwiej wybrać najlepszą.
Na różnice w odpowiedziach wpływa też okno kontekstu. Model językowy ChatGPT bierze pod uwagę tylko określoną długość rozmowy, liczoną w tokenach. W bardzo długim czacie wcześniejsze ustalenia, np. wymagany ton czy limit długości, mogą przestać działać. Stąd wrażenie, że ChatGPT zapomina wcześniejszą rozmowę, choć jej początek po prostu wypadł poza zakres, który model analizuje.
Skąd model wie, co napisać – trening i dostrajanie
Pretrening – nauka języka na ogromnych zbiorach tekstów
Pierwszy etap to pretrening. Model analizuje bardzo duże zbiory tekstów, m.in. ogólnodostępne strony internetowe, i stale ćwiczy jedno zadanie, czyli przewidywanie dalszego ciągu tekstu. Przy okazji przyswaja gramatykę, różne style, typowe struktury wypowiedzi, np. budowę instrukcji, listu czy recenzji, oraz powiązania między pojęciami.
Po tym etapie model sprawnie dopisuje tekst, ale nie potrafi jeszcze prowadzić rozmowy. Zamiast odpowiedzieć na pytanie, mógłby dopisać do niego kolejne pytania, bo tak często wyglądają zestawy pytań w tekstach, na których się uczył.
Dostrajanie do rozmowy
Asystentem model staje się dopiero po dostrojeniu. Najpierw uczy się na przykładach dialogów, a potem na ocenach ludzi, którzy porównują kilka jego odpowiedzi i wskazują lepszą. Tę metodę nazywa się uczeniem ze wzmocnieniem na podstawie informacji zwrotnej od ludzi (RLHF). Dzięki niej ChatGPT odpowiada na polecenie w formie pomocnej rozmowy, zamiast tylko dopisywać ciąg dalszy.
Wzorce zamiast zapamiętanych tekstów
Model nie przechowuje kopii przeczytanych tekstów, tylko uogólnione wzorce. Dlatego zwykle tworzy nowe zdania. Przy popularnych formułach, znanych cytatach i fragmentach, które w danych treningowych powtarzały się wiele razy, zdarzają się jednak zdania identyczne z oryginałem albo bardzo do niego zbliżone. Przed publikacją tekstu z czatu warto porównać cytaty i charakterystyczne sformułowania ze źródłem.
Data graniczna wiedzy
Wiedza modelu kończy się na danych treningowych. Może nie wiedzieć o wydarzeniach, zmianach przepisów ani nowych produktach, które pojawiły się później. Mimo to często udzieli odpowiedzi opartej na starszych informacjach. Inaczej jest wtedy, gdy aplikacja ma dostęp do aktualnych stron internetowych i korzysta z nich przy odpowiedzi.
Historia ChatGPT – od laboratorium OpenAI do czatu
Fundamenty – OpenAI i architektura transformer
OpenAI powstało w 2015 roku jako organizacja badawcza zajmująca się sztuczną inteligencją. W pierwszych latach prowadziło głównie projekty badawcze, a nie tworzyło produktów dla zwykłych użytkowników.
Przełom technologiczny przyszedł spoza OpenAI. W 2017 roku zespół badaczy Google opublikował artykuł „Attention Is All You Need”, w którym opisał architekturę transformer z mechanizmem uwagi. Na tym rozwiązaniu opierają się wszystkie modele GPT, a litera „T” w ich nazwie pochodzi właśnie od słowa „transformer”.
Kolejne generacje GPT
Rodzina GPT rozwijała się etapami:
- GPT-1 (2018) pokazał, że model wstępnie wytrenowany na dużym zbiorze tekstów można potem dostosować do różnych zadań językowych.
- GPT-2 (2019) pisał już na tyle płynnie, że jego możliwości wywołały dyskusję o ryzyku masowego tworzenia tekstów.
- GPT-3 (2020) był znacznie większy od poprzedników i radził sobie z wieloma zadaniami na podstawie samego polecenia, często bez dodatkowego trenowania.
Każda kolejna generacja miała więcej parametrów, uczyła się na większej ilości danych i tworzyła spójniejsze, dłuższe wypowiedzi.
Premiera ChatGPT i dalszy rozwój
ChatGPT udostępniono publicznie pod koniec 2022 roku. Nie była to zupełnie nowa technologia, tylko dialogowa wersja istniejącego modelu, dostrojona do prowadzenia rozmowy. O jej popularności zdecydowały prosty interfejs czatu i to, że z modelu mógł skorzystać każdy, bez wiedzy technicznej.
Później pojawiły się kolejne modele oraz obsługa obrazu i głosu, a sama aplikacja zyskała nowe funkcje. Nazwy wersji, ich możliwości i dostępność w poszczególnych planach zmieniają się często.
Porównania modeli i opisy funkcji sprzed kilku miesięcy mogą być już nieaktualne. Przed wyborem wersji do pracy lub nauki sprawdź jej opis w aktualnej dokumentacji OpenAI.
Do czego wykorzystać generowanie treści w ChatGPT
Generowanie treści w ChatGPT najbardziej pomaga na początku pracy. Daje szybszy pierwszy szkic, dopasowuje styl i ton do odbiorcy oraz przerabia jeden tekst na różne kanały, np. newsletter, post i krótki komunikat. Żeby powstała gotowa, sprawdzona treść, nadal potrzebny jest człowiek, który zweryfikuje fakty i umie poprawić tekst z AI tak, by brzmiał naturalnie.
Teksty i opisy
ChatGPT przygotuje szkice artykułów, wpisów blogowych, opisów produktów, scenariuszy i krótkich form literackich. Jakość wyniku zależy od tego, ile informacji zawiera polecenie. Warto w nim określić rolę, grupę odbiorców, długość, ton i strukturę tekstu.
Przykład polecenia: „Jesteś redaktorem bloga o ogrodnictwie. Napisz szkic wpisu dla początkujących działkowców, ok. 600 słów, rzeczowym i przystępnym tonem. Struktura: krótki wstęp, trzy śródtytuły, na końcu lista najczęstszych błędów”.
Pomysły i burza mózgów
ChatGPT sprawdza się jako partner do szukania tematów artykułów, koncepcji kampanii czy planu spotkania. Najlepsze efekty daje prośba o kilka różnych wariantów zamiast jednej odpowiedzi, np. dziesięć tematów w trzech ujęciach: poradnikowym, eksperckim i lekkim. Spośród nich wybierasz najlepsze i prosisz o rozwinięcie tylko tych.
Obsługa klienta
W firmie ChatGPT może działać jako asystent odpowiadający na typowe pytania, np. o czas dostawy czy procedurę zwrotu, na podstawie firmowej bazy wiedzy. Taki asystent potrzebuje jasno określonego zakresu tematów, w których może odpowiadać.
Równie ważna jest reguła przekazania sprawy człowiekowi. Reklamacje, skargi, nietypowe przypadki i pytania spoza bazy wiedzy powinny trafiać do pracownika, a nie do kolejnej wygenerowanej odpowiedzi.
Ograniczenia modelu, o których trzeba pamiętać
Halucynacje, czyli przekonująco podane błędy
Model potrafi podać nieistniejące fakty, liczby, cytaty, a nawet całe źródła z tytułem i autorem. Nie jest to rzadka usterka, tylko skutek sposobu działania. Model wybiera tokeny, które pasują do kontekstu, a nie sprawdza prawdziwości informacji. Zmyślony tytuł publikacji brzmi więc równie wiarygodnie jak prawdziwy.
Najczęściej problem dotyczy szczegółów, np. dat, statystyk, numerów przepisów i nazwisk. Im bardziej konkretna i rzadko opisywana informacja, tym większe ryzyko, że zostanie dopowiedziana.
Ogólnikowość i powtarzalność
Nowy tekst nie zawsze wnosi coś wartościowego. Bez konkretnych danych od użytkownika, takich jak przykłady z firmy, liczby, opinie klientów czy własne doświadczenia, model składa treść z najbardziej typowych sformułowań. Taki tekst jest poprawny, ale pusty i podobny do wielu innych.
Charakterystyczne objawy to ogólne wstępy, wyliczenia oczywistych zalet i zdania pasujące do każdego tematu. Pomaga dostarczenie modelowi materiału, z którego ma korzystać, zamiast oczekiwania, że sam go wymyśli.
Niszowe tematy i lokalne realia
Model słabiej radzi sobie z wąskimi zagadnieniami i polskimi realiami. Dotyczy to zwłaszcza prawa, przepisów branżowych, procedur urzędowych i cen. Odpowiedzi w tych obszarach bywają nieaktualne, uproszczone albo oparte na rozwiązaniach z innych krajów.
W sprawach prawnych, finansowych i zdrowotnych odpowiedź czatu może posłużyć najwyżej jako punkt wyjścia do rozmowy z prawnikiem, doradcą lub lekarzem, a nie jako podstawa decyzji.
Zmienność wyników
OpenAI regularnie aktualizuje modele, a po zmianie styl i jakość odpowiedzi mogą wyglądać inaczej. Polecenie, które wcześniej dawało dobry efekt, po aktualizacji może zwracać dłuższe, krótsze albo inaczej sformatowane teksty. Sprawdzone prompty, zwłaszcza używane w stałych procesach w firmie, warto co jakiś czas przetestować ponownie i w razie potrzeby poprawić.
Jak pracować z ChatGPT skutecznie i bezpiecznie
Dobre polecenie i poprawki w tej samej rozmowie
Skuteczny prompt odpowiada na pytania, które zadałby sobie autor tekstu. W jakiej sytuacji powstaje treść, czemu ma służyć, kto ją przeczyta i w jakiej formie ma być gotowa? Dużo daje przykład, np. fragment wcześniejszego tekstu, którego styl model ma naśladować, albo wzór tabeli do wypełnienia.
Gdy wynik nie pasuje, lepiej doprecyzować polecenie w kolejnej wiadomości, niż zaczynać rozmowę od nowa. Model ma wtedy w kontekście pierwszą wersję i wie, co zmienić. Prośba „skróć o połowę, usuń wstęp, dodaj przykład z branży budowlanej” zwykle działa lepiej niż ponowne, ogólne polecenie.
Weryfikacja przed publikacją
Fakty, liczby, daty i źródła z odpowiedzi trzeba sprawdzić w niezależnych materiałach, np. w oficjalnych serwisach instytucji, dokumentacji technicznej lub publikacjach, do których można dotrzeć samodzielnie. Źródła, którego nie da się odnaleźć, nie należy cytować.
Przed publikacją lub wysłaniem tekst trzeba przeczytać krytycznie. Sprawdź, czy twierdzenia są prawdziwe, czy ton pasuje do odbiorcy i czy w tekście nie zostały ogólniki bez treści.
Prywatność i zasady w firmie
Do czatu nie należy wpisywać:
- danych osobowych, własnych i cudzych,
- haseł, kodów dostępu i kluczy,
- danych klientów i kontrahentów,
- poufnych dokumentów firmy, np. umów, raportów czy planów.
Zamiast nich lepiej opisać sytuację w sposób zanonimizowany, bez nazwisk, nazw firm i numerów.
W ustawieniach konta warto sprawdzić opcje historii czatów oraz wykorzystania rozmów do trenowania modeli. Nazwy tych opcji i ich domyślne wartości zależą od planu i mogą się zmieniać. W pracy ChatGPT powinien być używany wyłącznie w ramach narzędzi i reguł zatwierdzonych przez pracodawcę.
Zanim wkleisz do czatu materiał z pracy, zapytaj dział IT lub przełożonego, jakie dane mogą trafiać do zewnętrznych narzędzi AI. Odpowiedź zapisz jako stałą regułę dla siebie i zespołu.
Najczęściej zadawane pytania
Czy da się rozpoznać, że tekst napisał ChatGPT?
Nie ma metody, która robi to pewnie. Detektory tekstów AI często się mylą: oznaczają teksty pisane przez ludzi jako wygenerowane i przepuszczają treści z czatu po drobnej redakcji. Ich wynik może być najwyżej sygnałem do rozmowy z autorem, a nie dowodem, zwłaszcza w szkole i na uczelni.
Czy tekst wygenerowany przez ChatGPT można publikować jako własny?
Regulamin OpenAI zwykle pozwala użytkownikowi korzystać z wygenerowanych treści, ale aktualne warunki warto sprawdzić samodzielnie. Ochrona prawnoautorska tekstu stworzonego w całości przez AI jest niepewna. Szkoły, wydawcy i pracodawcy często mają też własne zasady, np. obowiązek ujawnienia użycia AI. W sprawach spornych lepiej poradzić się prawnika.
Jak dobrze ChatGPT pisze po polsku?
ChatGPT zwykle tworzy po polsku teksty płynne i w większości poprawne gramatycznie. Zdarzają się jednak kalki z angielskiego, sztywny szyk zdania, nienaturalne związki frazeologiczne i błędy w odmianie rzadkich nazw własnych. Tekst przeznaczony do publikacji warto przeczytać na głos i poprawić fragmenty, które brzmią jak tłumaczenie.
Czym ChatGPT różni się od innych chatbotów opartych na modelach językowych?
Większość popularnych chatbotów działa podobnie i przewiduje kolejne fragmenty tekstu. Różnią się modelem i jego dostawcą, danymi treningowymi, dostępem do internetu, integracjami z innymi narzędziami, limitami w planach oraz zasadami przetwarzania danych. Przed wyborem narzędzia do pracy dobrze jest przetestować kilka z nich na tych samych zadaniach i porównać ich polityki prywatności.